先说结论:我给一个自回归(AR)大模型和一个掩码扩散(masked-diffusion)大模型布置了同一个不可能的任务:记住纯随机噪声。两者参数量完全一样。结果它们的记忆容量差不多;但反转在于:扩散模型要多花约 10 倍的训练步数才能到达同样的容量,而且过了某个数据规模后,它撞上一堵怎么也翻不过去的墙。扩散模型的瓶颈不是记忆容量,而是优化。
这个实验是读了 Morris 等人的 “How much do language models memorize?”(估计 GPT 类模型每个参数能存约 3.6 bit)之后顺手做的。很自然的追问是:LLaDA 那类扩散语言模型,存得更多、更少,还是差不多?
实验设置(一段话讲完)
给模型喂 64 位的随机比特串。里面没有任何结构可学,所以它复现出的每一个 bit 都是纯记忆;记住的比特数 = H(x) − H(x|θ)。用同一个 约 20.1 万参数的 transformer,两种训练方式:AR(因果、精确 NLL)和扩散(双向、LLaDA 掩码目标,用伪对数似然 PLL 打分:遮住一个 token,用其余 63 个去预测它)。不断增大数据集 N,各自训练到饱和,读出峰值记忆比特数。参数量相同,所以是公平对比。
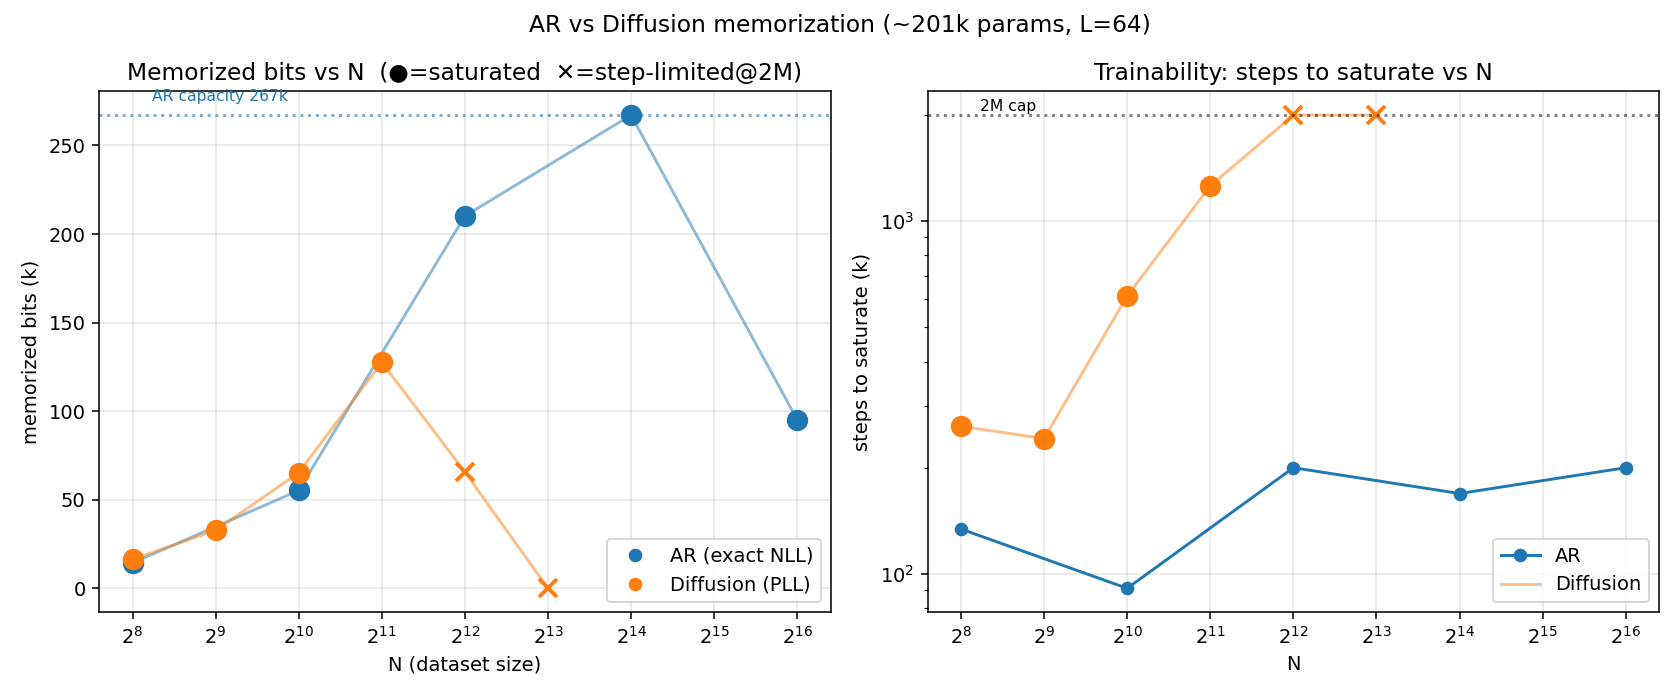
实际发生了什么
| N(数据集) | AR 比特(饱和步数) | 扩散 比特(步数) |
|---|---|---|
| 256 | 14.3k (134k) | 16.4k (262k) ✅ |
| 1024 | 55.3k (91k) | 65.3k (614k) ✅ |
| 2048 | 无 | 127.5k (1.26M) ✅ |
| 4096 | 210k (200k) | ~66k (2M,仍在爬升) ❌ |
| 16384 | 267k (169k) | 无 |
AR 画出一条漂亮的曲线:记忆量随 N 上升,在 约 267k 比特(1.33 bit/参数)见顶,然后回落。它是受容量限制的:装满了就停。扩散模型在 N=2048 之前能全部记住,之后就面朝地摔了下去:N=4096 时,训练了 200 万步也只爬到约 25–50%,而且我拔掉插头的那一刻它还在涨。
为什么“扩散存得更多”是指标在骗你
在相同的 N 下,扩散看起来存得更多(N=1024 时 65.3k vs 55.3k)。其实并没有。这个差值恰好等于 log₂N 的前缀开销:AR 模型每条序列都要先花约 log₂N 个 bit,去搞清楚自己在从左到右解码的是 N 条中的哪一条,而它的单样本损失也确实几乎精确落在 log₂N 上(N=256 时 8.09 bit,N=1024 时 10.04,N=4096 时 12.69)。扩散的 PLL 一上来就把 64 个 token 露出 63 个,序列身份从不成问题,这个开销约等于 0。是量尺不同(L − log₂N vs L),不是记忆不同。
真正的差别在于“可训练性”
完全记住所需的步数:262k → 614k → 1.26M → 撞墙。 N 每翻一倍,步数大致翻一倍,过了 N≈4096 就彻底失败。而 AR 全程都能在约 10–20 万步内到顶。用任意顺序的掩码目标去记忆噪声,优化起来就是要命地难,哪怕货架空间是一样的。
一句话
AR 和扩散的记忆容量相近;只是扩散训练到那个容量要难得多。 AR 的墙是空间,扩散的墙是步数;而且这里扩散的数字还是个下界(N=4096 从没跑到饱和),所以它真实的容量很可能就紧挨着 AR。结论是:只要给足步数,扩散模型也会把它能装下的东西全记住,只不过一路上更少地做泛化。